「ナレッジグラフについてうまく説明できない」
「生成AIとナレッジグラフの関係は?」
そこでナレッジグラフの基礎知識からメリット、自社の必要度チェック、ナレッジグラフの具体的な活用事例、作り方の5ステップ、構築ツール9選までを順に見ていきましょう。
DXの事例や機能を1冊に、「DXまるわかりガイド」全67ページ
CONTENTS
ナレッジグラフとは?基礎知識と仕組み
ナレッジグラフとは、情報のつながりを点と線で表現したデータ構造です。
従来のデータベースが行や列でデータを蓄えるのに対し、ナレッジグラフは対象を点、関係を線としてグラフのように表現します。単なる文字列ではなく、事物の意味と関係でデータを扱う点が大きな特徴です。
| 項目 | 詳細 |
|---|---|
| 1. ナレッジグラフの基本構造 | 実体と関係性をつなぎ、知識を意味のネットワークにする仕組み |
| 2. 図解で見るナレッジグラフ | 「主語→述語→目的語」の3点セット(トリプル)で情報を構造化する |
| 3. 実際に使うナレッジグラフ | 顧客・製品・契約・従業員をつなぎ、業務判断に必要な関係性を引き出す |
| 4. なぜ今注目される?生成AI(GraphRAG)活用 | ベクトル検索(意味の近い文を数値で探す方法)を使うRAGを補完し、業務用語や関係性を踏まえて答える |
1. ナレッジグラフの基本構造
ナレッジグラフは、ノード(点)とエッジ(線)で構成されます。ノードは対象そのものを、エッジは対象と対象のつながりを表します。
| 要素 | 役割 | 例 |
|---|---|---|
| ノード | 人・モノ・場所・概念など、情報の主役になる「1つの単位」 | ハチ公、秋田犬、上野英三郎、渋谷駅 |
| エッジ | 2つのノードをつなぐ矢印で、ノード同士の関係を示す | 犬種、飼われている、設置場所 |
この構造の強みは、関係をたどる検索に強いことです。従来のデータベースは、知りたい情報が増えるほどテーブルの結合が重なり、検索が重くなりがちです。一方ナレッジグラフは、各ノードが隣のノードへの参照を直接持つため、データが増えても関係をたどる手間が増えにくい傾向があります。
規模が大きいデータほど、この差は開きやすくなります。
2. 図解で見るナレッジグラフ
グラフのノードとエッジを1件のデータとして書き下したものが、主語・述語・目的語からなる「トリプル」です。
たとえば「ハチ公(主語)の飼い主は(述語)上野英三郎(目的語)」といった形です。ナレッジグラフの情報は、すべてこの3点セットの集合として表現されます。トリプルを何万件、何億件と積み重ねることで、膨大な事実がひとつのネットワークとしてつながっていきます。
図では、ハチの飼い主が上野英三郎であること、ハチが渋谷駅に毎日通ったこと、ハチ公像が渋谷駅に設置されていることの3つの関係が、1枚のグラフに収まっています。「ハチ公は秋田犬で、飼い主は上野英三郎博士だった」といった事実も、エッジをたどるだけで引き出せます。
3. 実際に使うナレッジグラフ
実際の業務では、数百〜数千のノードと、数万〜数十万のエッジを扱うこともあります。
ナレッジグラフで扱う代表的な例
- 顧客 - 担当する - 営業担当者
- 製品 - 構成する - 部品・マニュアル・障害履歴
- 契約 - 対象とする - 製品・顧客・期間
- 案件 - 承認する - 決裁者
- 従業員 - 所属する - 部署・プロジェクト
ナレッジグラフを構築すれば、部門ごとに分かれていた情報が、意味のつながりで結ばれます。その結果、1つの問いに、複数のシステムをまたいだ答えを返せるようになります。
4. なぜ今注目される?生成AI(GraphRAG)活用
ナレッジグラフは生成AIを業務で使う際の「精度不足」を補う手段として期待されています。
AIの精度を上げる方法として一般的なRAG(検索拡張生成)は、文書を細かく分け、意味の近いものを引く仕組みです。文書の中身をピンポイントで取り出せる一方、推論や、文書をまたいだ要約、根拠の追跡は苦手です。
この弱点を補うためにナレッジグラフとRAGを組み合わせた構成が「GraphRAG」です。
| 項目 | 従来のRAG | GraphRAG |
|---|---|---|
| データの持ち方 | 文書を分割してベクトル化 | 実体と関係を構造化して保持 |
| 得意な問い | ピンポイントの事実確認 | 関係の推論、全体像の要約 |
| 業務用語への対応 | 類似語の揺れに弱い | オントロジー(用語と関係の決まりをまとめた設計図)で用語をそろえられる |
| 回答の根拠 | 文書片の類似度を提示 | たどったエッジで説明できる |
たとえば「AさんはB社を退職後、C社の役員に就任した。C社の親会社Dは、当社と競合関係にある」という4段の連鎖は、単なる類似度検索では拾えません。ナレッジグラフは関係の型(退職・就任・親会社・競合)を保持しているため、こうしたつながりを順にたどれます。
また、生成AIを実務で使うときの大きな壁が、もっともらしい嘘、いわゆるハルシネーションです。GraphRAGは回答の根拠となる事実を明示的に管理するため、「どの事実をたどってこの結論に至ったか」を後から確認でき、ハルシネーションの抑制にも役立ちます。
脱アナログから一元管理まで、
現場が変わった24社のリアルを公開
業種や機能ごとのDX成功事例を1冊に。自社に合うヒントがきっと見つかります。
フォーム入力1分・即ダウンロード可
ナレッジグラフ導入で得られる3つの効果
1. 業務用語で自然に回答が返る
ナレッジグラフは、同じ意味を指す複数の呼び方を1つの実体にひも付けられます。そのため、業界固有の略称や社内独自の呼称にも対応できます。
たとえば営業部が「機器」、施工部が「装置」、保守部が「設備」と呼んでいた対象を1つにまとめれば、どの呼び方で検索しても同じ答えが返ります。過去文書の取りこぼしも減ります。
業務用語をそろえることで解決できること
- 製品コードと通称・略称・型番の対応関係を1つに集約
- 部署名の改称・統廃合を履歴付きでたどり、過去文書との整合を維持
- 用語辞書のメンテナンスをAIチームだけでなく現場側でも運用可能
2. 部門横断で情報をたどれる
部門ごとに散らばった情報も、ナレッジグラフでは1つのネットワークとしてつながります。顧客の問い合わせを起点に、「複数のシステムをまたぐ問い」を一度にたどれます。
| 従来の情報連携 | ナレッジグラフ導入後 |
|---|---|
| 複数のシステムに別々に問い合わせ、手作業で突き合わせる | 1つの問いでエッジをたどり、関連する情報をまとめて取れる |
| 担当者の記憶に頼って関係を組み立て直す | 関係がグラフに残り、誰でも同じ結果を引き出せる |
| 答えが出るまでに時間がかかる | つながりのある情報がすぐにそろい、判断の初動が早まる |
効果が大きいのは緊急対応の初動です。たとえば、「この機器で似た故障が過去になかったか」をその場で確認できます。
3. 判断基準を組織の知識として残せる
「この条件のときはこの承認ルート」「この製品には必ずこの部品」といったベテランの判断基準は、多くの企業で暗黙知として個人に依存しています。ナレッジグラフはこうした業務ルールを関係として構造化できるため、担当者が異動・退職しても組織の知識として残ります。
組織の知識として残せる代表例
- 承認・稟議のルートと金額の基準
- 製品構成の依存関係と互換性の条件
- 顧客ごとの過去対応履歴(担当者・障害・契約と結んで蓄積)
ナレッジグラフ必要度チェック
自社にナレッジグラフの導入がどれほど必要か、以下のチェックリストで確認してみましょう。合計12点以上が、RAG単体では頭打ちに近づいているサインの目安です。その場合は、3カ月程度のPoC(本格導入の前に小さく試して効果を確かめる検証)を検討する段階です。
10問でナレッジグラフ導入の必要度と、見直すべきナレッジ管理課題がわかります
※ 実際の状況は条件によって異なる場合があります。本診断結果はあくまでも目安としてご利用ください。
ナレッジグラフの活用事例4選
CASE1. 約50億のエンティティの事実を、検索結果のパネルに
導入後の変化
ナレッジパネルの情報は、まるで巨大なバーチャル百科事典のような「ナレッジグラフ」に基づいています……これは、ウェブ全体で共有されているデータ、オープンソース データベース、ライセンスされたデータベースから、エンティティに関する事実と情報を識別するシステムです。ナレッジグラフには、約50億のエンティティに関する5000億を超える事実が蓄積されています。
現場で起きた主な出来事
- ウェブ全体で数百のソースからナレッジグラフは構成されている
- モバイルではナレッジグラフの情報が単一のナレッジパネルに表れるのではなく、複数のナレッジパネルが検索結果画面上で分割されて表示される場合がある
- Google はそうしたフィードバックを分析し、不正確な情報がどのようにシステムを通過したかを理解することで、ナレッジグラフ全体の改善に努めている
※ Google「Google 検索のナレッジグラフとナレッジパネルとは」2020年5月26日
CASE2. 契約書のリスクを示すツールを、ナレッジグラフで開発
導入前の悩み
通常は、知財室や弁護士がチェックを行いますが、チェックと修正の往復により、契約締結までの時間がかかってしまうケースがあります。
技術開発本部 大木様
導入後の変化
本ツールでは、契約書の文書構造を解析し、解析した契約書の内容とリスクチェックの観点を紐づけることで、リスク該当箇所を特定します……構築されたナレッジグラフにより、どの記述箇所がなぜリスクとなるかも併せて確認することができ、スムーズな修正を支援します。
技術開発本部 大木様
※ 株式会社NTTデータ「ヒトの思考ロジックをなぞらえる『ナレッジグラフ技術』」2020年6月8日
CASE3. ナレッジグラフで、理由つきの推薦を実データで試した
導入後の変化
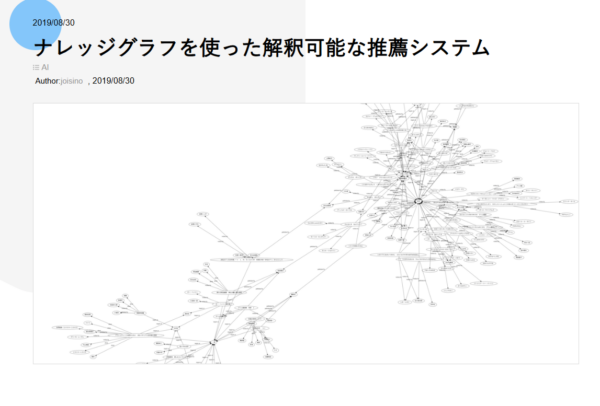
インターンでは、ナレッジグラフを使った推薦システムをメルカリの実データを用いて検証を行いました……実験では、解釈可能な推薦や、属性間の推薦など、従来の協調フィルタリングベースの推薦では不可能だったタスクが、実行可能になったことを確認しました。
株式会社メルカリ
現場で起きた主な出来事
- メルカリのカタログデータから独自のナレッジグラフを構築した
- 推薦商品を見ると、高校生向けの参考書を推薦できている
※ 株式会社メルカリ「ナレッジグラフを使った解釈可能な推薦システム」2019年8月30日
CASE4. 障害の因果をたどるナレッジグラフ拡張RAGを開発
導入前の悩み
RAGベースの手法では事例毎に断片的に解析する事しかできません。そのため、過去に起きた障害と全く同一の障害原因を提示するくらいしかできませんでした。
人工知能研究所 菊月様
導入後の変化
既存技術の課題を解決するために我々が提唱したのが因果ナレッジグラフで、これを用いて複雑な因果関係を分析し、網羅的に質の高い障害原因分析をしたり、さらに切り分け手順等も提示したり、といったことを可能にしています……これによって、因果ナレッジグラフの自動構築を可能としました。
人工知能研究所 菊月様
現場で起きた主な出来事
- ナレッジグラフから関係性を踏まえた知識を生成AIに正確に与えることができ、論理推論や出力根拠を示すことが可能
- 2024年7月より、AIサービス Fujitsu Kozuchi(R&D)のラインナップとして順次提供を開始いたした
ナレッジグラフの作り方5ステップ
STEP1. ユースケースの決定
最初に、ナレッジグラフで解きたい問いを1つに絞り、具体的なユースケースを固定します。目的が曖昧なまま全データを扱おうとすると、設計が肥大化して収拾がつかなくなります。
| 具体的なユースケース例 | 狙う効果 |
|---|---|
| 顧客360度ビューの構築 | 問い合わせ対応時間の短縮・解約リスクの早期検知 |
| 製品構成と障害履歴のひも付け | 障害の再発防止と原因分析の高速化 |
| 契約条項と法規制のリンク | 法改正時の影響範囲をすぐに特定 |
STEP2. オントロジー設計
ユースケースが決まったら、その問いに答えるのに必要な「実体(エンティティ)」と「関係(リレーション)」を洗い出します。オントロジー設計はナレッジグラフ全体の骨格になるため、ここで用語の揺れや粒度のズレを解消しておかないと、後工程でやり直しが発生します。
1. エンティティを定義する
顧客・製品・契約・案件・従業員など、対象ドメインに登場する実体を洗い出す。同じ意味を指す別称(略称・旧称・製品コード)を1つの実体に統合する。
2. リレーションを定義する
「担当する」「使う」「承認する」「構成する」といった関係を、能動態の動詞で命名する。方向性(誰から誰へ)と多重度(1対1・1対多・多対多)も明示する。
3. ルールと制約を書き出す
「契約は必ず顧客と製品を持つ」「承認者は決裁権限を持つ従業員に限る」など、業務ルールを制約条件として言語化する。この工程が後の回答精度を左右する。
業界標準のオントロジーが公開されている場合は、流用できないかを先に検討すると設計工数を抑えられます。
STEP3. データ収集とトリプル化
社内のDB、文書ファイル、Excel、社外の公開データなど、各システムからデータを収集します。
| 代表的なデータソース | 抽出のポイント |
|---|---|
| RDB・DWH(データウェアハウス。分析用にデータを集めた保管庫) | 主キー・外部キーから、エンティティとリレーションを機械的に抜き出す |
| CRM・SFA・基幹システム | APIで顧客・案件・活動履歴を取り出し、実体にひも付ける |
| 文書(PDF・Word・議事録) | LLMによる固有表現抽出でエンティティ候補を推定する |
集めたデータからは、主語・述語・目的語の三つ組(トリプル)を取り出します。従来はルールベースやNLPが主流でしたが、近年はLLMで非構造化テキストから直接トリプルを抽出する構成が増えています。
STEP4. グラフDBに格納し、GraphRAGと接続
整えたトリプルをグラフデータベースに入れ、生成AIから呼び出せる状態にします。ここで初めて、ナレッジグラフとして「使える」形になります。
1. クエリインターフェースを整える
SPARQLやCypherといったグラフクエリ言語(グラフDBからデータを取り出す命令の書き方)を、LLMが自然言語から自動生成できるようにする。生成に失敗したときの代替処理も設計する。
2. ベクトル検索と組み合わせる
グラフから得た実体・関係の情報と、周辺文書のベクトル検索結果を合わせてLLMへ渡す。回答の根拠としてたどったエッジをそのまま提示できるようにする。
3. 回答精度を評価する
STEP1で決めたユースケースに沿って、正答率・応答時間・根拠の妥当性の3指標で測る。数値目標を事前に決めておき、改善の材料にする。
ナレッジグラフを単体で使うのではなく、ベクトル検索で周辺文書を集めるRAGと組み合わせることで、業務の判断に要る文脈をまとめてAIに渡せます。
STEP5. 運用と拡張
作って終わりではなく、運用こそが本番です。業務の変化に合わせて、ルールを当てて新たな関係を導いたり、データの更新・監視やオントロジーの改訂を続けたりします。
| 運用フェーズの主なタスク | 担当のイメージ |
|---|---|
| オントロジーの改訂 | 業務側の主管とアーキテクトで四半期ごとに見直し |
| データパイプラインの監視 | データエンジニアが差分投入・整合性チェックを日次で運用 |
| ユースケースの追加 | 最初の1ユースケースが軌道に乗ったら隣接ドメインへ拡張 |
データエンジニア・情報アーキテクト・業務側の3者で運用チームを組成しておくと、拡張フェーズで失敗しにくくなります。
ナレッジグラフ構築・管理ツール9選
ナレッジグラフの構築は、単一の製品で完結せず「オントロジー設計・グラフDB・統合基盤」の3つを組み合わせるのが一般的です。
1. オントロジー設計ツール

用語と関係を定義し、可視的に設計するためのツール群です。ナレッジグラフの骨格を作り、業務用語やルールを言語化します。無料または低コストで利用できるものも多くあります。
| サービス名 | 料金(税込) | 機能 |
|---|---|---|
| Protégé/WebProtégé | 無料 | スタンフォード大学発のオープンソース。学習用途から実務まで幅広く使える定番。クラウド版のWebProtégéはブラウザ上で複数人が同時に編集できる |
| PoolParty Semantic Suite | 要問い合わせ | 語彙管理・タクソノミー編集・グラフDB連携を統合したエンタープライズ向けスイート |
| TopBraid EDG | 要問い合わせ | エンタープライズデータガバナンスに強く、社内のマスターデータ管理と組み合わせやすい |
※ 月額料金は一般的なプランにおける価格設定
※ 2026年9月時点
2. グラフデータベース

設計が固まったら、ナレッジグラフの実データを保管し、関係性を高速にたどるためのデータベースが必要になります。GraphRAGの中核となる層で、性能・スケール・クラウド連携の観点から選定します。
| サービス名 | 料金(税込) | 機能 |
|---|---|---|
| Neo4j | 従量課金 | 世界中で広く利用されているグラフDB。大量データの高速な検索性と直感的なクエリ言語が強み。マネージド版Auraは無料枠あり |
| Amazon Neptune | 従量課金 | RDFとプロパティグラフ両対応で、Bedrock・SageMakerとの連携がしやすい。既存がAWS環境であれば統合が容易 |
| TigerGraph | 45USD〜 | 大規模グラフの高速分析に強く、深い関係性の探索を要する金融・通信分野の採用が多い。無料トライアルあり |
※ 月額料金は一般的なプランにおける価格設定
※ 2026年9月時点
3. 統合データ基盤プラットフォーム
オントロジー設計・グラフDB・データ統合・生成AI連携までを1つのプラットフォームで提供するツールです。複数システムをつなぐ手間と費用を抑えやすくなります。
| サービス名 | 料金(税込) | 機能 |
|---|---|---|
| Stardog | 要問い合わせ | エンタープライズナレッジグラフ基盤。仮想化とGraphRAG向けAI機能を標準搭載 |
| Palantir Foundry | 要問い合わせ | オントロジー中心の設計思想で、大手製造・金融・公共の実績が豊富 |
| Google Cloud Enterprise Knowledge Graph | 要問い合わせ | Google公開ナレッジと社内データを結合し、Vertex AIとGeminiで活用できるマネージド基盤 |
※ 月額料金は一般的なプランにおける価格設定
※ 2026年9月時点
ナレッジグラフでよくある質問
── 導入コストと期間の目安は?
始め方によって幅は大きく、無料の設計ツールで始めれば、費用をかけずにPoCまで進めることもできます。本格運用では、グラフDBのライセンス、データ連携の開発、権限管理、保守費用が加わります。下の表の費用と期間は目安で、規模や体制によって変わります。
| 段階 | 使うツール | 費用感 | 期間の目安 |
|---|---|---|---|
| 設計・試作 | Protégéなど設計ツール | 無料から開始できる | 1〜2カ月 |
| PoC | Neo4j無料版など | 無料〜数十万円 | 2〜3カ月 |
| 本格運用 | グラフDB有償版 | 数百万円〜(規模により変動) | 6〜12カ月 |
| 全社統合 | 統合データ基盤 | 数千万円〜要問い合わせ | 12カ月以上 |
いきなり全社統合を目指すと、稟議も社内調整も重くなります。まず1つの業務でPoCを回し、数値で効果を示してから予算を積み増す進め方が現実的です。
── オントロジーやグラフDBとは?
ナレッジグラフを調べる中で、セットで登場するのが「オントロジー」と「グラフDB(データベース)」です。この3つは混同しがちですが、役割が異なります。
| 用語 | 役割 |
|---|---|
| オントロジー | 概念と関係の意味を定義する設計図 |
| ナレッジグラフ | 設計図に基づいて実データを点と線でつないだネットワーク |
| グラフデータベース | 実データを保管し、すばやく検索する基盤 |
オントロジーは「どんな種類のノードと関係を、どういうルールで結ぶか」を先に決めておく設計図、グラフDBは、ノードとエッジをそのまま格納・検索するために最適化されたデータベースです。
簡単に言うとオントロジーが設計図、グラフDBが箱、ナレッジグラフが中身、という関係になります。
── 既存のデータと連携できる?
連携できます。ナレッジグラフは既存システムの上に載せる想定で設計する製品が多く、データを置き換える必要はありません。
代表的な連携パターン
- DWHから差分抽出し、グラフDBへ日次でロードする
- 文書管理・社内Wikiの文書はLLMで固有表現を抽出し、実体候補としてエッジ化
- CRM・ERPとはAPI連携で顧客・案件・契約データを取り込む
既存基盤を壊さず、意味の層だけを重ねるのがナレッジグラフの導入モデルです。DWHは事実の保管、ナレッジグラフは関係の保管、と役割を分けて設計するとメンテナンスが楽になります。
── 専門知識がなくても社内で作れる?
用語の洗い出しと関係の整理は、業務を理解している現場担当者が中心となって進めます。ここは業務経験のある人にしか書けない部分です。一方、実装、複数システムとのデータ連携、グラフDBの運用には、データ設計や開発の知識が必要になります。
担う役割は次の3つです。
| 役割 | 担うこと |
|---|---|
| 業務側の主管 | 用語・ルール・判断基準の一次情報を出す |
| 情報アーキテクト | オントロジーの組み立て・細かさの調整・食い違いのチェック |
| データエンジニア | グラフDBへの投入・パイプライン・運用の監視 |
現実的な体制は、業務担当者が意味やルールを決め、社内のシステム担当か外部エンジニアがシステムへ実装する分担です。オントロジー設計ツールのProtégéやWebProtégéはノーコードに近い感覚で扱えるため、業務担当者が初期設計を進め、その成果物をエンジニアが引き取る流れを取りやすくなります。
業務側を巻き込めるかが成否を分けます。設計を情報システム部門だけで進めると、現場の用語やルールとズレが出て、あとの工程で作り直しが起きやすくなります。